Ein Text soll in eine Spalte, die genau 255 Bytes fasst. Der Code kürzt mit substr(), und in der Datenbank landet am Ende ein Fragezeichen oder eine Fehlermeldung. Der Grund ist immer derselbe: Der Schnitt liegt mitten in einem Zeichen.
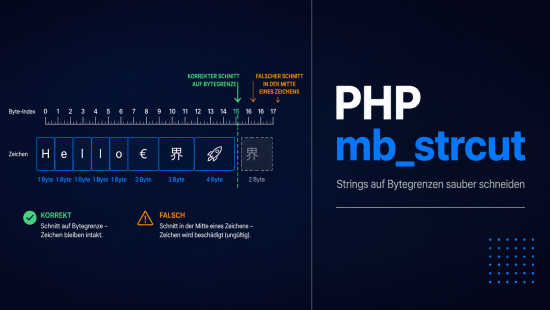
Im Bild liegt der Schnitt auf einer Zeichengrenze, nicht innerhalb eines Blocks. Genau darin unterscheidet sich die Funktion von den beiden Nachbarn.
Was PHP mb_strcut() macht
PHP mb_strcut() schneidet einen Ausschnitt aus einer Zeichenkette heraus. Start und Länge werden dabei in Bytes angegeben, das Ergebnis endet aber niemals mitten in einem Mehrbyte-Zeichen. Passt das letzte Zeichen nicht mehr vollständig in die Grenze, lässt die Funktion es weg.
<?php

$text = 'Grüße aus Berlin';   /* in UTF-8: "ue" und "ss" belegen je 2 Byte */


echo strlen($text);      // 20 Bytes

echo mb_strlen($text);   // 18 Zeichen


echo mb_strcut($text, 0, 5, 'UTF-8');   /* "Gru" plus Rest, sauber begrenzt */
Die beiden ersten Ausgaben zeigen bereits den Kern des Themas: dieselbe Zeichenkette hat zwei Längen, je nachdem, ob Bytes oder Zeichen gezählt werden. Wer die falsche Einheit benutzt, rechnet aneinander vorbei.
Die Signatur im Original
Die Beschreibung im Handbuch nennt den entscheidenden Unterschied zu mb_substr() bereits im ersten Satz:
mb_strcut(string $string, int $start, ?int $length = null,

          ?string $encoding = null): string


/* string   - the string to get part of string from

   start    - the byte offset to start at, not the character offset

   length   - the length in bytes of the returned portion

   encoding - the character encoding, defaults to the internal one

   return   - returns the portion of string specified by the start and

              length parameters, as a value that never splits a

              multi-byte character in the middle


   The result is cut on byte boundaries, starting from the given offset,

   and shortened if the last characters would not fit completely.

   See the manual for the difference to mb_substr(). */
Die beiden Angaben in Bytes statt in Zeichen sind der ganze Kern: Genau daraus ergibt sich das Verhalten, das dieses Tutorial beschreibt.
substr(), mb_substr() und mb_strcut() am gleichen Beispiel
Drei Funktionen, dieselbe Eingabe, dieselbe Zahl, drei verschiedene Ergebnisse. Der direkte Vergleich erklärt mehr als jede Beschreibung.
<?php

$text = 'München';   /* 8 Zeichen, 9 Bytes in UTF-8 */


$a = substr($text, 0, 3);              /* 3 Bytes, roh */

$b = mb_substr($text, 0, 3, 'UTF-8');  /* 3 Zeichen */

$c = mb_strcut($text, 0, 3, 'UTF-8');  /* hoechstens 3 Bytes, sauber */


var_dump(strlen($a), strlen($b), strlen($c));

/* int(3) int(4) int(2) */
Das Ergebnis von substr() hat zwar drei Bytes, das dritte davon ist aber die Hälfte eines Zeichens und damit unbrauchbar. mb_substr() liefert drei vollständige Zeichen und belegt dafür vier Bytes, sprengt die Grenze also. Nur PHP mb_strcut() hält die Bytegrenze ein und liefert trotzdem gültigen Text.
| Funktion | Einheit | Zeichen bleiben ganz | Typischer Einsatz |
substr() | Bytes | nein | reiner ASCII-Text |
mb_substr() | Zeichen | ja | Anzeige, Zeichenzahl vorgegeben |
mb_strcut() | Bytes | ja | Speicher- und Protokollgrenzen |
Wer Texte für die Anzeige kürzt und dabei auf Wortgrenzen achten will, ist mit einem dritten Weg besser bedient. Das Tutorial zum Kürzen von Strings ohne abgeschnittene Wörter zeigt ihn. Hier geht es ausschließlich um Fälle, in denen eine Bytegrenze von außen vorgegeben ist.
Wer zählt Bytes und wer zählt Zeichen
Die Verwirrung entsteht selten bei PHP mb_strcut() selbst, sondern beim Zusammenspiel mit anderen Funktionen. Diese Übersicht räumt sie aus.
<?php

$text = 'Straße 12';


/* Byte-Seite */

echo strlen($text);              // 11

echo strpos($text, '12');        // 9  (Byteposition)


/* Zeichen-Seite */

echo mb_strlen($text);           // 10

echo mb_strpos($text, '12');     /* 8  (Zeichenposition) */
strlen() und strpos() gehören zur Byte-Seite, mb_strlen() und mb_strpos() zur Zeichen-Seite. PHP mb_strcut() gehört trotz des Präfixes zur Byte-Seite und passt deshalb zu strpos(), nicht zu mb_strpos(). Wer eine Fundstelle aus strpos() weiterverarbeitet, hat damit die passende Schnittfunktion.
Praxis: Werte für eine Datenbankspalte kürzen
Spalten mit fester Bytegrenze kommen häufiger vor als gedacht, besonders in gewachsenen Systemen und bei älteren Zeichensätzen. Die Kürzung gehört vor das Schreiben, nicht in die Datenbank.
<?php

function aufBytes(string $wert, int $maxBytes): string

{

    if (strlen($wert) <= $maxBytes) {

        return $wert;

    }


    return mb_strcut($wert, 0, $maxBytes, 'UTF-8');

}


$bezeichnung = aufBytes($eingabe, 255);


$stmt = $dbh->prepare('UPDATE artikel SET bezeichnung = ? WHERE id = ?');

$stmt->execute([$bezeichnung, $id]);


var_dump(strlen($bezeichnung) <= 255); /* bool(true), garantiert */
Die Prüfung mit strlen() vorab spart den Aufruf, wenn der Wert ohnehin passt. Wie die Abfrage selbst abgesichert wird, zeigt das Tutorial zu PHP mysqli Prepared Statements.
Praxis: Mail-Betreff und Protokollfelder
Bei Mail-Headern ist die Zeilenlänge in Bytes begrenzt. Wichtig ist die Reihenfolge: erst kürzen, dann kodieren. Wer zuerst kodiert, kürzt anschließend die Kodierung kaputt, und einzelne Mailprogramme zeigen dann Kauderwelsch.
<?php

$roh = 'Ihre Bestellung über große Mengen wurde bestätigt und versandt';


/* erst auf Bytes kuerzen */

$kurz = mb_strcut($roh, 0, 60, 'UTF-8');


/* danach kodieren */

$betreff = mb_encode_mimeheader($kurz, 'UTF-8', 'B');


mail('kunde@beispiel.de', $betreff, $text);
Dasselbe gilt für Protokollfelder mit fester Breite und für Schnittstellen, die Datensätze zeichenweise positionieren. Auch dort zählt der Empfänger Bytes, und PHP mb_strcut() ist die einzige der drei Funktionen, die in dieser Einheit rechnet und trotzdem gültigen Text liefert.
Praxis: Datensätze mit fester Feldbreite
Bei Austauschformaten mit fester Feldbreite wird nach dem Kürzen aufgefüllt. str_pad() rechnet ebenfalls in Bytes, beide Funktionen passen also zusammen.
<?php

function feld(string $wert, int $breite): string

{

    $kurz = mb_strcut($wert, 0, $breite, 'UTF-8');


    return str_pad($kurz, $breite, ' ', STR_PAD_RIGHT);

}


$zeile = feld('Schrauben verzinkt groß', 20)

       . feld('4711', 8)

       . feld('Stk', 4);


echo strlen($zeile); // 32, unabhaengig vom Inhalt
Würde hier mb_substr() zum Kürzen und str_pad() zum Auffüllen benutzt, verschiebt sich der Satz bei jedem Umlaut um ein Byte. Der Empfänger liest dann ab dem ersten Sonderzeichen alles falsch.
Die Kodierung gehört immer angegeben
Der vierte Parameter ist optional, und genau das ist die Falle. Ohne Angabe benutzt PHP mb_strcut() den Wert aus mb_internal_encoding(), und der hängt von der Serverkonfiguration ab. Lokal funktioniert der Code, auf dem Server kommt ein leeres oder falsches Ergebnis zurück.
<?php

echo mb_internal_encoding();   /* je nach Server: UTF-8 oder ISO-8859-1 */


/* riskant */

$a = mb_strcut($text, 0, 30);


/* eindeutig */

$b = mb_strcut($text, 0, 30, 'UTF-8');
Die Regel ist einfach: Die Kodierung steht in jedem Aufruf. Das kostet zwölf Zeichen und erspart eine Fehlersuche, die erfahrungsgemäß erst im Produktivbetrieb beginnt.
Welche der drei Funktionen die richtige ist, hängt allein daran, woher die Grenze kommt.
flowchart TD
  A[Grenze kommt von wo] --> B{Bytes vorgegeben}
  B -->|ja| C[mb_strcut]
  B -->|nein| D{Zeichen zaehlen}
  D -->|ja| E[mb_substr]
  D -->|nein| F{Nur Anzeige kuerzen}
  F -->|ja| G[mb_strimwidth]
Kommt die Grenze aus einer Datenbank, einem Protokoll oder einer Schnittstelle, ist sie fast immer in Bytes angegeben.
Negative Werte für Start und Länge
Wie die verwandten Funktionen versteht PHP mb_strcut() auch negative Angaben. Ein negativer Start zählt vom Ende der Zeichenkette, eine negative Länge lässt so viele Bytes am Ende weg.
<?php

$text = 'Rechnung-2026-08-4711.pdf';


echo mb_strcut($text, -4, null, 'UTF-8');   // .pdf

echo mb_strcut($text, 0, -4, 'UTF-8');      /* Rechnung-2026-08-4711 */
Bei reinem ASCII wie in diesem Beispiel verhalten sich alle drei Schnittfunktionen gleich. Interessant wird es erst, wenn Mehrbyte-Zeichen im Spiel sind, und dann ist die Byteangabe nur mit PHP mb_strcut() gefahrlos.
Emojis und zusammengesetzte Zeichen
Ein Emoji belegt in UTF-8 vier Bytes. Auch dieses Zeichen bleibt entweder vollständig erhalten oder fällt weg, zerschnitten wird es nicht. Bei zusammengesetzten Sequenzen ist die Aussage allerdings zu begrenzen.
<?php

$text = 'Danke! 👍';


/* das Emoji faellt ganz weg, statt kaputt zu gehen */

echo mb_strcut($text, 0, 8, 'UTF-8');   /* "Danke!" plus Leerzeichen */


/* aber: Flaggen und Familien bestehen aus mehreren Codepoints */

$flagge = "🇩🇪";           /* zwei Zeichen ergeben eine Flagge */

echo strlen(mb_strcut($flagge, 0, 4, 'UTF-8')); /* 4, nur die halbe Flagge */
Ein einzelner Codepoint bleibt also unversehrt, eine Sequenz aus mehreren kann auseinanderfallen. Wer das ausschließen muss, arbeitet mit den Graphem-Funktionen aus der intl-Erweiterung, etwa grapheme_substr(). Für Datenbankspalten und Protokollfelder reicht PHP mb_strcut() in aller Regel.
Zum Nachrechnen der Byteangaben in diesem Tutorial: Die Beispiele stehen im Quelltext mit echten Zeichen, ein Umlaut belegt darin zwei Bytes, ein Emoji vier. Wer die Werte selbst prüfen will, gibt zu jedem Beispiel zusätzlich strlen() und mb_strlen() aus. Verwandte Funktionen aus derselben Familie behandelt auch das Tutorial zu strtoupper() und mb_strtoupper().
Fazit
PHP mb_strcut() füllt eine Lücke zwischen zwei bekannteren Funktionen: Es rechnet in Bytes wie substr() und respektiert Zeichengrenzen wie mb_substr(). Gebraucht wird das immer dann, wenn die Grenze von außen kommt, aus einer Spalte, einem Header oder einem Datensatzformat.
Zwei Gewohnheiten reichen für den sicheren Einsatz: die Kodierung in jedem Aufruf angeben und vorher wissen, ob die Grenze in Bytes oder in Zeichen gilt. Alles Weitere ergibt sich daraus von selbst.