Eine Konfigurationszeile soll an der ersten Trennstelle geteilt werden, und als Trenner gelten Gleichheitszeichen, Doppelpunkt und Tabulator. Mit drei strpos()-Aufrufen und einem min() darüber geht das irgendwie, schön ist es nicht. PHP strpbrk erledigt denselben Fall in einer Zeile: Die Funktion sucht das erste Vorkommen eines beliebigen Zeichens aus einer Menge und gibt die Zeichenkette ab dieser Fundstelle heraus. Sie stammt aus der C-Standardbibliothek, daher der sperrige Name. Und sie hat eine Eigenheit, an der fast jeder erste Versuch scheitert: PHP strpbrk() liefert weder eine Position noch einen Wahrheitswert, sondern einen String.
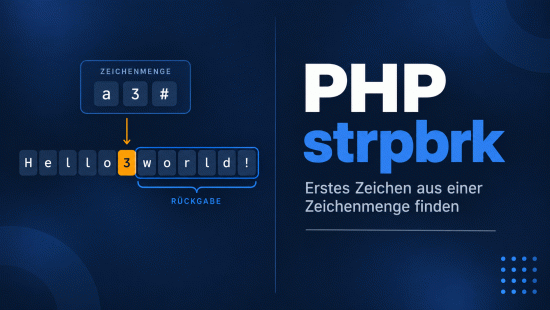
Oben steht die gesuchte Zeichenmenge, unten die Zeichenkette, hervorgehoben der erste Treffer und alles, was dahinter folgt. Dieser hintere Teil ist der Rückgabewert, und genau diese Aufteilung zeigt das Bild.
Was PHP strpbrk() zurückgibt
Der zweite Parameter ist keine Zeichenfolge, die so vorkommen muss, sondern eine Liste einzelner Kandidaten. Sobald irgendeines dieser Zeichen auftaucht, endet die Suche. Zurück kommt nicht das gefundene Zeichen allein und auch nicht seine Position, sondern der gesamte Reststring einschließlich dieses Zeichens.
<?php

$zeile = 'timeout:30';

$rest = strpbrk($zeile, '=:');


var_dump($rest);

/* string(3) ":30" */
Wer von explode() kommt, erwartet an dieser Stelle 30 und bekommt :30. Das ist kein Versehen im Entwurf, sondern praktisch: Aus dem ersten Zeichen des Rückgabewerts lässt sich ablesen, welcher der erlaubten Trenner es denn nun war. Bei PHP strpbrk() steht diese Information gratis im Ergebnis, während man sie sich bei drei getrennten Suchläufen erst wieder zusammensuchen müsste.
Syntax: die Signatur im Original
Zwei Parameter, ein Union-Rückgabetyp. Zusammengefasst sieht die Funktion so aus:
<?php

strpbrk(

    string $string,

    string $characters

): string|false


/* string: the subject to search in

   characters: a list of single characters,

   order and duplicates do not matter,

   no escaping, every byte stands for itself

   returns the portion of string starting

   at the first character found, or

   false when none of them occurs */
Das |false im Rückgabetyp ist die eigentliche Warnung. Eine lose Abfrage wie if (strpbrk(...)) sieht harmlos aus und geht schief, sobald der Reststring genau "0" lautet. Dieser Fall ist selten, aber er tritt ein, wenn das gesuchte Zeichen eine Null am Zeilenende ist. PHP betrachtet die Zeichenkette "0" als unwahr, und der Zweig wird übersprungen, obwohl ein Treffer vorlag.
<?php

$eingabe = 'stufe0';


if (strpbrk($eingabe, '019')) {

    echo 'Ziffer gefunden';

}

/* keine Ausgabe, der Rest ist "0" */


if (strpbrk($eingabe, '019') !== false) {

    echo 'Ziffer gefunden';

}

/* Ziffer gefunden */
Die Zeichenmenge und ihre Eigenheiten
Die Menge wird zeichenweise gelesen. Reihenfolge und Doppelungen wirken sich nicht aus, 'abc' verhält sich wie 'cba' und wie 'aabbcc'. Maskierung gibt es nicht: Punkt, Sternchen, Klammer und Backslash stehen für sich selbst. Genau das macht PHP strpbrk() gegenüber einer Zeichenklasse im regulären Ausdruck so bequem, denn dort müsste man an Sonderfälle wie das Minuszeichen oder die schließende eckige Klammer denken.
Groß- und Kleinschreibung werden dagegen unterschieden, und eine Variante mit i-Verhalten existiert nicht. Bei Satzzeichen fällt das nie auf, bei Buchstabenmengen sofort. Wer beide Schreibweisen treffen will, schreibt sie beide in die Menge. Eine leere Menge liefert immer false, weil es nichts zu finden gibt.
Die Position des Treffers steht nicht im Rückgabewert, lässt sich aber in einer Zeile ausrechnen. Die Differenz der beiden Stringlängen ist der gesuchte Index, und damit taugt PHP strpbrk() auch für Fehlermeldungen mit Spaltenangabe.
<?php

$zeile = 'timeout:30';

$rest = strpbrk($zeile, '=:');


if ($rest !== false) {

    $pos = strlen($zeile) - strlen($rest);

    echo $pos;

    /* 7 */

}
PHP strpbrk() gegen strcspn() und strstr()
Drei Funktionen arbeiten an derselben Fundstelle und geben Verschiedenes heraus. strcspn() und strspn() zählen, wie weit es bis zum Treffer ist. strstr() sucht eine feste Folge statt einer Auswahl. Die Wahl hängt also allein daran, ob man die Entfernung braucht oder den Inhalt.
| Funktion | Zweiter Parameter | Ergebnis bei Treffer | Ergebnis ohne Treffer |
| strpbrk() | Zeichenmenge, jedes Zeichen gilt einzeln | Reststring ab dem Treffer | false |
| strcspn() | Zeichenmenge, jedes Zeichen gilt einzeln | Länge des Anfangsstücks als Zahl | Länge der ganzen Zeichenkette |
| strstr() | fester Teilstring, muss genau so vorkommen | Reststring ab dem Teilstring | false |
| strchr() | fester Teilstring, Alias von strstr() | Reststring ab dem Teilstring | false |
flowchart TD
    A[String + Zeichenmenge] --> B[strcspn]
    A --> C[strpbrk]
    A --> D[strstr]
    B --> E[Position als Zahl]
    C --> F{Treffer?}
    F -- ja --> G[Rest ab Treffer]
    F -- nein --> H[false]
    D --> I[Rest ab Teilstring]
<?php

$s = 'host=db.local:3306';


var_dump(strcspn($s, '=:'));

/* int(4) */


var_dump(strpbrk($s, '=:'));

/* string(14) "=db.local:3306" */


var_dump(strstr($s, '=:'));

/* bool(false) */
Solange ein Treffer existiert, entspricht strpbrk($s, $z) dem Ausdruck substr($s, strcspn($s, $z)). Diese Gleichsetzung gilt jedoch nur bis zum Fehlerfall: Ohne Treffer gibt strcspn() die volle Stringlänge zurück, substr() daraus einen leeren String, PHP strpbrk() dagegen false. Wer die Position braucht, nimmt also strcspn(), wer den Rest braucht, diese Funktion hier. Ein Nachbau des einen mit dem anderen bringt nur eine zusätzliche Fehlerquelle.
Ein Blick auf die Herkunft räumt zwei Verwechslungen aus. In C lautet die Funktion char *strpbrk(const char *s, const char *accept) und liefert einen Zeiger auf die Fundstelle, sonst NULL. PHP gibt an dieser Stelle keinen Zeiger zurück, sondern eine Kopie des Reststrings, und statt NULL kommt false. Zur selben Familie gehören strspn() und strcspn(), die in PHP die Namen aus C behalten haben. Die dritte C-Funktion dieser Gruppe heißt strchr() und sucht dort genau ein Zeichen, in PHP ist strchr() dagegen nur ein zweiter Name für strstr() und sucht eine ganze Zeichenfolge. Wer aus C kommt und in PHP strchr() schreibt, bekommt deshalb nicht, was er erwartet, und braucht PHP strpbrk() mit einer einelementigen Menge.
Die erste Trennstelle in einer Konfigurationszeile
Eine Zeile wie start=08:15 darf nur am Gleichheitszeichen geteilt werden, obwohl der Doppelpunkt ebenfalls ein erlaubter Trenner ist. Weil PHP strpbrk() beim ersten Treffer stehenbleibt, löst sich dieser Fall von selbst. Die Uhrzeit auf der rechten Seite bleibt unangetastet, und eine Zeile ganz ohne Trenner fällt sauber durch.
<?php

$zeilen = [

    'timeout:30',

    'host=db.local',

    'start=08:15',

    'kaputt',

];


foreach ($zeilen as $zeile) {

    $rest = strpbrk($zeile, '=:');

    if ($rest === false) {

        echo $zeile, ' ohne Trenner', PHP_EOL;

        continue;

    }

    $schnitt = strlen($zeile) - strlen($rest);

    $name = substr($zeile, 0, $schnitt);

    $wert = substr($rest, 1);

    echo $name, ' = ', $wert, PHP_EOL;

}

/* timeout = 30 */

/* host = db.local */

/* start = 08:15 */

/* kaputt ohne Trenner */
Der Tabulator lässt sich derselben Menge einfach hinzufügen, ohne dass sich am Ablauf etwas ändert. Genau dieser Punkt trägt auch spätere Wünsche: Ein weiterer erlaubter Trenner kostet ein Zeichen in der Menge und keine zusätzliche Verzweigung. Bei einer Kette aus strpos()-Aufrufen wäre jeder neue Trenner ein weiterer Aufruf, ein weiterer Vergleich und eine weitere Stelle, an der ein false unbemerkt durchrutschen kann.
Query-String und Anker von einer Adresse trennen
Bei einer vollständigen Adresse ist parse_url() das richtige Werkzeug, daran gibt es nichts zu rütteln. Für Bruchstücke und relative Pfade, wie sie aus einem href-Attribut oder aus einer Weiterleitungsregel kommen, ist es dagegen ein schwerer Hammer. Hier reicht eine Menge aus zwei Zeichen. Ob zuerst das Fragezeichen oder zuerst das Rautezeichen kommt, muss man nicht wissen, denn PHP strpbrk() nimmt, was zuerst auftaucht. Zur Kodierung der Werte dahinter gehört dann urlencode().
<?php

$adresse = '/suche/ergebnis?q=php#treffer3';

$rest = strpbrk($adresse, '?#');


if ($rest === false) {

    $pfad = $adresse;

    $anhang = '';

} else {

    $schnitt = strlen($adresse) - strlen($rest);

    $pfad = substr($adresse, 0, $schnitt);

    $anhang = $rest;

}


echo $pfad, PHP_EOL;   /* /suche/ergebnis */

echo $anhang, PHP_EOL; /* ?q=php#treffer3 */
Eingaben auf verbotene Zeichen prüfen
Beim Prüfen eines Dateinamens interessiert selten nur das Ja oder Nein. Eine Meldung wie Das Zeichen : ist nicht erlaubt hilft dem Benutzer weiter, eine Meldung wie ungültiger Name nicht. Da der Rückgabewert mit dem beanstandeten Zeichen beginnt, steht es an Position null bereit. Dieselbe Idee trägt beim Maskieren von CSV-Feldern: Nur wenn Semikolon, Anführungszeichen oder ein Zeilenumbruch vorkommen, muss das Feld in Anführungszeichen gesetzt werden.
<?php

function verstoss(string $n, string $v): ?string

{

    $rest = strpbrk($n, $v);

    return $rest === false ? null : $rest[0];

}


$verboten = '/\:*?"<>|';

$treffer = verstoss('Bericht:Q3.pdf', $verboten);


if ($treffer !== null) {

    echo 'Nicht erlaubt: ', $treffer, PHP_EOL;

}

/* Nicht erlaubt: : */


function csv_feld(string $wert): string

{

    $kritisch = ';"' . "\r\n";

    if (strpbrk($wert, $kritisch) === false) {

        return $wert;

    }

    return '"' . str_replace('"', '""', $wert) . '"';

}
Tempo, Regex und die Bytegrenze
Für eine reine Zeichenmenge ist PHP strpbrk() schneller als preg_match() mit einer Zeichenklasse, weil kein Muster übersetzt und kein Automat aufgebaut wird. Der Abstand ist in einer einzelnen Schleife nicht zu bemerken und wird erst bei Millionen Durchläufen sichtbar. Der wichtigere Punkt ist die Lesbarkeit: strpbrk($s, '=:') erklärt sich beim ersten Hinsehen. Sobald jedoch Wiederholungen, Gruppen, Anker oder Rückverweise ins Spiel kommen, ist der reguläre Ausdruck das richtige Werkzeug, und dann lohnt kein Rechenspiel.
Eine harte Grenze gibt es bei mehrbyteigen Zeichen. Die Funktion arbeitet auf Bytes, also wird auch die Zeichenmenge in einzelne Bytes zerlegt. Ein ü in der Menge bedeutet für PHP strpbrk() nicht ein Zeichen, sondern zwei Bytes, und jedes davon schlägt für sich an. Im Beispiel unten wird nach einem ü gesucht und ein ß gefunden, weil beide Zeichen in UTF-8 mit demselben ersten Byte beginnen.
<?php

$s = 'Straße';


var_dump(strpbrk($s, 'ü'));

/* string(3) "ße" */


if (preg_match('/[üö]/u', $s) === 1) {

    echo 'sauber gesucht';

}

/* keine Ausgabe: "Straße" hat weder ü noch ö,

   und genau das ist die richtige Antwort */
Im günstigen Fall stimmt das Ergebnis zufällig, im ungünstigen beginnt der Reststring mitten in einem Zeichen und ist dann kein gültiges UTF-8 mehr. Eine mb_strpbrk() gibt es im PHP-Kern nicht, und was unter diesem Namen im Netz kursiert, sind selbstgeschriebene Nachbauten. Für Mengen aus mehrbyteigen Zeichen bleibt preg_match() mit dem u-Modifikator. Solange die Menge nur aus ASCII-Zeichen besteht, also aus Satzzeichen, Ziffern und lateinischen Buchstaben, ist die Bytearbeit dagegen unkritisch, und das deckt den Großteil der Trennzeichenfälle ab.
Fazit
Der Rückgabewert ist der ganze Punkt: ein String ab der Fundstelle, sonst false. Wer das verinnerlicht hat, prüft mit !== false statt lose, liest den gefundenen Trenner aus dem ersten Zeichen und holt sich die Position über die Längendifferenz. PHP strpbrk() ersetzt damit eine ganze Reihe von strpos()-Aufrufen und bleibt dabei lesbar. Die Grenzen sind klar gezogen: feste Zeichenfolgen sind ein Fall für strstr(), reine Positionen einer für strcspn(), mehrbyteige Zeichenmengen einer für die Regex. Dazwischen bleibt genug Raum für eine Funktion, die im PHP-Alltag viel zu selten auftaucht.