Eine Auswertung auf der Kommandozeile listet Lieferanten, und alles sitzt sauber, bis zwei japanische Firmennamen im Datensatz auftauchen. Ab dieser Zeile rutscht die rechte Spalte nach außen, obwohl im ganzen Skript sorgfältig mb_strlen() steht. Dahinter steckt eine Unterscheidung, die deutsche Daten nie erzwingen: Anzeigebreite ist etwas anderes als Zeichenzahl. PHP mb_strwidth misst, wie viele Spalten ein Text in einer Festbreitenschrift belegt, und rechnet ostasiatische Schriftzeichen dabei doppelt. Auch mb_str_pad() aus dem Tutorial zu str_pad() rettet die Tabelle nicht, denn diese Funktion füllt nach Zeichen auf und nicht nach Spalten.
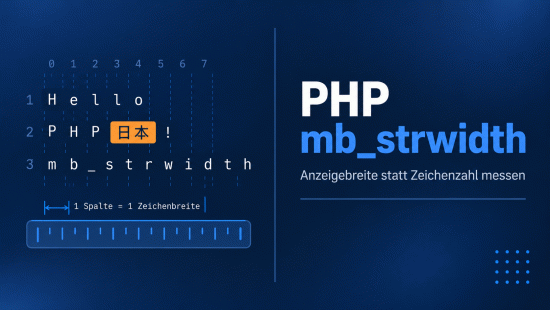
Drei Zeilen im selben Raster, und eine davon endet weiter rechts, weil ein einzelnes Zeichen zwei Gitterzellen belegt: Genau diesen Effekt hält das Bild fest. Warum das so ist und was dagegen hilft, steht in den nächsten Abschnitten.
Was PHP mb_strwidth() misst
Die Funktion liefert eine Spaltenzahl. Gemeint ist damit die Breite, die der Text in einer Schrift mit festen Zeichenabständen einnimmt, also im Terminal, im Editor oder in einem <pre>-Block. Die meisten Zeichen belegen eine Spalte. Chinesische, japanische und koreanische Schriftzeichen belegen zwei, ebenso die sogenannten Vollbreite-Varianten lateinischer Buchstaben. PHP mb_strwidth() addiert diese Einzelbreiten und gibt die Summe zurück.
Ein wichtiger Punkt gleich vorweg, weil er sonst die ganze Rechnung verdirbt: Umlaute belegen eine Spalte. Sie brauchen in UTF-8 zwar zwei Bytes, im Terminal stehen sie aber genauso breit wie ein a. Wer glaubt, deutscher Text sei deswegen ein Fall für PHP mb_strwidth(), hat das falsche Problem vor sich. Für reinen deutschen Text reicht mb_strlen().
Syntax: die Signatur im Original
Zwei Parameter, davon einer optional:
<?php

mb_strwidth(

    string $string,

    ?string $encoding = null

): int


/* string: the text to be measured

   encoding: a character encoding name,

   null falls back to the internal encoding

   returns the number of columns the string

   occupies in a monospaced context, where

   East Asian wide characters count as two */
Der Rückgabewert ist immer ein int und niemals false. Fehler gibt es hier praktisch keine, was die Funktion angenehm sorglos macht. Der zweite Parameter ist der einzige Ort, an dem etwas schiefgehen kann, und darum geht es weiter unten in einem eigenen Abschnitt.
Drei Funktionen, ein String, drei Zahlen
Das folgende Beispiel trägt den ganzen Text. Ein String aus deutschen und japanischen Zeichen, dreimal gemessen, und jede Messung liefert eine andere Zahl.
<?php

$s = 'Grüße 東京';


echo strlen($s), PHP_EOL;      /* 14 */

echo mb_strlen($s), PHP_EOL;   /* 8 */

echo mb_strwidth($s), PHP_EOL; /* 10 */
| Funktion | Einheit | Wert | Die richtige Wahl bei |
| strlen() | Bytes | 14 | Speicherbedarf und Bytegrenzen von Datenbankfeldern |
| mb_strlen() | Zeichen | 8 | Längenbegrenzungen im Formular, Zeichenzähler |
| mb_strwidth() | Spalten | 10 | Ausrichtung in Terminal, Log und Festbreitenschrift |
flowchart TD
    A{Was willst du wissen?}
    A --> B[Speicherbedarf]
    A --> C[Zeichenzahl]
    A --> D[Ausrichtung]
    B --> B1["strlen: Bytes"]
    C --> C1["mb_strlen: Zeichen"]
    D --> D1["mb_strwidth: Spalten"]
    D1 --> E{Zu breit?}
    E -- ja --> F[mb_strimwidth]
Die Byteanzahl ist für die Darstellung immer die falsche Zahl. Die Zeichenzahl ist richtig, solange man zählt und nicht ausrichtet. Erst PHP mb_strwidth() beantwortet die Frage, wie viel Platz der Text am Bildschirm braucht. Grundlagen zu Byte, Zeichen und UTF-8 stehen im Tutorial zu Multibyte-Strings.
Die Breitenregel hinter PHP mb_strwidth()
Die Regel stammt nicht von PHP, sondern aus Unicode. Zeichen aus den ostasiatischen Blöcken gelten als breit und bekommen zwei Spalten, alles andere eine. Terminals, Editoren und Schriftarten halten sich an dieselbe Festlegung, weshalb die Zahl aus PHP mb_strwidth() mit dem übereinstimmt, was der Benutzer sieht. Der direkte Vergleich einzelner Zeichen macht es deutlich.
<?php

foreach (['A', 'ä', '東', 'A'] as $z) {

    echo $z, ' | Bytes: ', strlen($z);

    echo ' | Zeichen: ', mb_strlen($z);

    echo ' | Spalten: ', mb_strwidth($z), PHP_EOL;

}

/* A | Bytes: 1 | Zeichen: 1 | Spalten: 1 */

/* ä | Bytes: 2 | Zeichen: 1 | Spalten: 1 */

/* 東 | Bytes: 3 | Zeichen: 1 | Spalten: 2 */

/* A | Bytes: 3 | Zeichen: 1 | Spalten: 2 */
Das letzte Zeichen ist ein lateinisches A in seiner Vollbreite-Variante, wie sie in japanischen Texten neben Kanji vorkommt. Es sieht aus wie ein A und ist für die Darstellung zwei Spalten breit. Genau solche Fälle machen eine Ausrichtung nach Zeichenzahl unzuverlässig.
Warum mb_str_pad() die Sache nicht löst
mb_str_pad() gibt es seit PHP 8.3, und sie ist für den häufigen Fall genau richtig: Sie beachtet Mehrbyte-Zeichen und füllt nicht mehr nach Bytes auf. Ihre Rechnung geht aber in Zeichen, und dort endet ihre Hilfe. Ein japanisches Zeichen ist ein Zeichen und belegt zwei Spalten. In einer Tabelle mit gemischten Daten füllt die Funktion deshalb zu weit auf, und die Spalte rutscht nach rechts.
<?php

$namen = ['Müller', '田中商事', 'Nowak'];


foreach ($namen as $n) {

    echo '|', mb_str_pad($n, 10), '|', PHP_EOL;

}

/* |Müller    | */

/* |田中商事      | */

/* |Nowak     | */


function breit_pad(string $t, int $b): string

{

    $fehlt = $b - mb_strwidth($t);

    return $t . str_repeat(' ', max(0, $fehlt));

}


foreach ($namen as $n) {

    echo '|', breit_pad($n, 10), '|', PHP_EOL;

}

/* |Müller    | */

/* |田中商事  | */

/* |Nowak     | */
Beide Ausgaben stehen absichtlich untereinander. Im ersten Block hängt der rechte Balken der zweiten Zeile vier Spalten zu weit draußen, weil vier Zeichen dort acht Spalten belegen. Im zweiten Block stimmt es, weil die Auffüllung auf PHP mb_strwidth() aufsetzt und nicht auf einer Zeichenzählung.
Kürzen mit mb_strimwidth()
Zum Messen gehört das Abschneiden. mb_strimwidth() begrenzt einen Text auf eine Spaltenbreite und setzt dabei nie mitten in ein Zeichen. Eine Eigenschaft dieser Funktion überrascht regelmäßig: Das Ersatzzeichen wird in die Zielbreite eingerechnet und nicht angehängt. Bei einer Zielbreite von 20 und drei Punkten als Markierung bleiben also 17 Spalten Text stehen.
<?php

$t = 'Wärmetauscher für Heizungsanlagen';


echo mb_strwidth($t), PHP_EOL;

/* 33 */


echo mb_strimwidth($t, 0, 20), PHP_EOL;

/* Wärmetauscher für He */


echo mb_strimwidth($t, 0, 20, '...'), PHP_EOL;

/* Wärmetauscher für... */
Direkt daneben steht mb_strcut(), und die beiden werden gern verwechselt. mb_strcut() aus dem Tutorial zu mb_strcut() schneidet auf Bytegrenzen und ist die richtige Wahl, wenn ein Datenbankfeld oder ein Protokollformat eine Byteschranke setzt. mb_strimwidth() schneidet auf Spaltenbreiten und ist die richtige Wahl für die Anzeige. Derselbe String, dieselbe Zahl 8, zwei verschiedene Ergebnisse.
<?php

$t = '東京特許許可局';


echo mb_strimwidth($t, 0, 8), PHP_EOL;

/* 東京特許 : vier Zeichen, acht Spalten */


echo mb_strcut($t, 0, 8), PHP_EOL;

/* 東京 : zwei Zeichen, sechs Bytes */
Praxis: eine CLI-Tabelle mit gemischtem Text
Der Rest ist Handwerk. Die Spaltenbreite ist das Maximum über alle Werte einer Spalte, gemessen mit PHP mb_strwidth(). Jeder Wert wird auf diese Breite begrenzt und anschließend mit Leerzeichen aufgefüllt. Der Rahmen ist nicht nur Zierde: Er macht sichtbar, ob die rechte Kante wirklich bündig sitzt.
<?php

$zeilen = [

    ['Artikel', 'Lieferant', 'Menge'],

    ['Schraube M4', 'Müller GmbH', '1200'],

    ['Dichtung', '田中商事', '80'],

    ['Kabelbinder', 'Wärmetechnik AG', '340'],

];


$breiten = [];

foreach ($zeilen as $zeile) {

    foreach ($zeile as $i => $wert) {

        $b = mb_strwidth($wert);

        $breiten[$i] = max($breiten[$i] ?? 0, $b);

    }

}


$trenner = '+';

foreach ($breiten as $b) {

    $trenner .= str_repeat('-', $b + 2) . '+';

}


echo $trenner, PHP_EOL;

foreach ($zeilen as $zeile) {

    $aus = '|';

    foreach ($zeile as $i => $wert) {

        $kurz = mb_strimwidth($wert, 0, $breiten[$i]);

        $rest = $breiten[$i] - mb_strwidth($kurz);

        $aus .= ' ' . $kurz

            . str_repeat(' ', $rest) . ' |';

    }

    echo $aus, PHP_EOL;

    echo $trenner, PHP_EOL;

}
Der Aufruf von mb_strimwidth() in der Schleife sieht überflüssig aus, weil die Breite ja das Maximum aller Werte ist. Er ist die Versicherung für den Tag, an dem jemand eine feste Obergrenze einbaut. Ohne ihn würde ein zu langer Wert den Rahmen sprengen, mit ihm bleibt die Tabelle in jedem Fall geschlossen.
Kodierung angeben oder nicht
Ohne zweiten Parameter arbeitet PHP mb_strwidth() mit der internen Kodierung. Die steht in der php.ini und lässt sich mit mb_internal_encoding() abfragen und setzen. In einem Projekt, das auf mehreren Servern läuft, ist die Angabe im Aufruf die sicherere Wahl, denn eine abweichende Einstellung auf dem Zielsystem fällt sonst erst in der Ausgabe auf.
<?php

echo mb_internal_encoding(), PHP_EOL;

/* UTF-8 */


$t = 'Grüße';

echo mb_strwidth($t, 'UTF-8'), PHP_EOL;

/* 5 */


echo mb_strwidth($t, 'ISO-8859-1'), PHP_EOL;

/* 7 */
Die zweite Zahl ist kein Fehler der Funktion. Unter ISO-8859-1 ist jedes Byte ein Zeichen, aus fünf Buchstaben werden sieben Bytes, und damit meldet PHP mb_strwidth() sieben Spalten. Wer die Kodierung falsch angibt, bekommt eine falsche Zahl, ohne dass irgendetwas warnt.
Die ehrliche Grenze: Emoji und kombinierende Zeichen
Hier endet die Hilfe. PHP mb_strwidth() rechnet je Codepunkt, nicht je sichtbarem Zeichen. Ein Emoji mit Hautton oder ein Beruf mit Verbindungszeichen besteht aus mehreren Codepunkten, die zusammen ein einziges Bild ergeben. Die Funktion zählt sie einzeln und liegt daneben: Im Beispiel unten ergibt das fünf Spalten für ein Bild, das im Terminal zwei belegt, also mehr als das Doppelte. Nicht jede zusammengesetzte Folge trifft es. Eine Flagge aus zwei Regionalindikatoren kommt auf zwei Spalten und stimmt damit, weil keiner der beiden Codepunkte als breit gilt und die Summe zufällig passt. Dasselbe gilt in die andere Richtung für kombinierende Zeichen: Ein nachgestellter Akzent verbindet sich mit dem Buchstaben davor und belegt null Spalten, wird aber mitgerechnet.
<?php

$emo = "\u{1F469}\u{200D}\u{1F4BB}";


echo mb_strlen($emo), PHP_EOL;       /* 3 */

echo mb_strwidth($emo), PHP_EOL;     /* 5 */

echo grapheme_strlen($emo), PHP_EOL; /* 1 */


$akz = "e\u{0301}";


echo mb_strwidth($akz), PHP_EOL;     /* 2 */

echo grapheme_strlen($akz), PHP_EOL; /* 1 */
grapheme_strlen() aus der intl-Erweiterung zählt zusammengesetzte Zeichen richtig, sagt aber ihrerseits nichts über die Breite. Eine Funktion im PHP-Kern, die beides zugleich leistet, gibt es nicht. Wer Emoji in ausgerichteten Tabellen darstellen will, kommt um eine eigene Tabelle der Breitenwerte nicht herum. Der Weg dorthin führt über grapheme_strlen() oder IntlBreakIterator, um den Text erst in sichtbare Zeichen zu zerlegen, und dann über eine eigene Zuordnung, die jedem dieser Zeichen eine Breite gibt. Zwei Spalten je Emoji sind dabei die Annahme, mit der die meisten Terminals arbeiten. Für Texte aus Namen, Artikelbezeichnungen und Schriftsystemen ohne Emoji bleibt PHP mb_strwidth() dagegen zuverlässig.
Fazit
Drei Fragen, drei Funktionen: strlen() für Bytes, mb_strlen() für Zeichen, PHP mb_strwidth() für Spalten. Wer eine Tabelle ausrichtet, ein Log formatiert oder eine Konsolenausgabe baut, braucht die dritte Zahl und kommt mit den ersten beiden nicht ans Ziel. Zum Messen gehört mb_strimwidth() als passendes Abschneidewerkzeug, mit der Eigenheit, dass das Ersatzzeichen von der Zielbreite abgeht. Und es bleibt eine Grenze: Emoji-Folgen und kombinierende Zeichen rechnet die Funktion falsch. Das ist verschmerzbar, solange man es weiß.